Como destrinchar o prompt de qualquer imagem de IA em segundos (Midjourney, Flux)
Publicado em 28 de outubro de 2026 · 6 min de leitura
Você está no Discord ou numa galeria e uma imagem te faz parar: a luz, a textura e o enquadramento são exatamente o que você queria. O que a maioria faz em seguida é apertar os olhos e chutar. Escreve "cinematic portrait, soft light", sai algo parecido e lá se vai uma hora de ajustes.
O problema não é o seu olho. Uma imagem é um resultado, e o resultado esconde quais decisões o produziram. Separar tudo em decisões independentes é bem mais rápido do que tentar adivinhar o conjunto inteiro.
Por que chutar um prompt longo de uma vez não funciona
Uma imagem pronta junta escolhas independentes: quem aparece, como foi feita, como está iluminada, como está enquadrada. Se você chuta tudo ao mesmo tempo, errar em um ponto (a sensação da lente está errada, a luz está dura demais) obriga a reescrever tudo, e você nem sabe qual parte tinha acertado.
Divida a imagem em átomos
O mysnipbox organiza o que um modelo de visão enxerga em seis categorias fixas, então o resultado sempre tem o mesmo formato:
| Categoria | A pergunta que responde | Exemplos de tags |
|---|---|---|
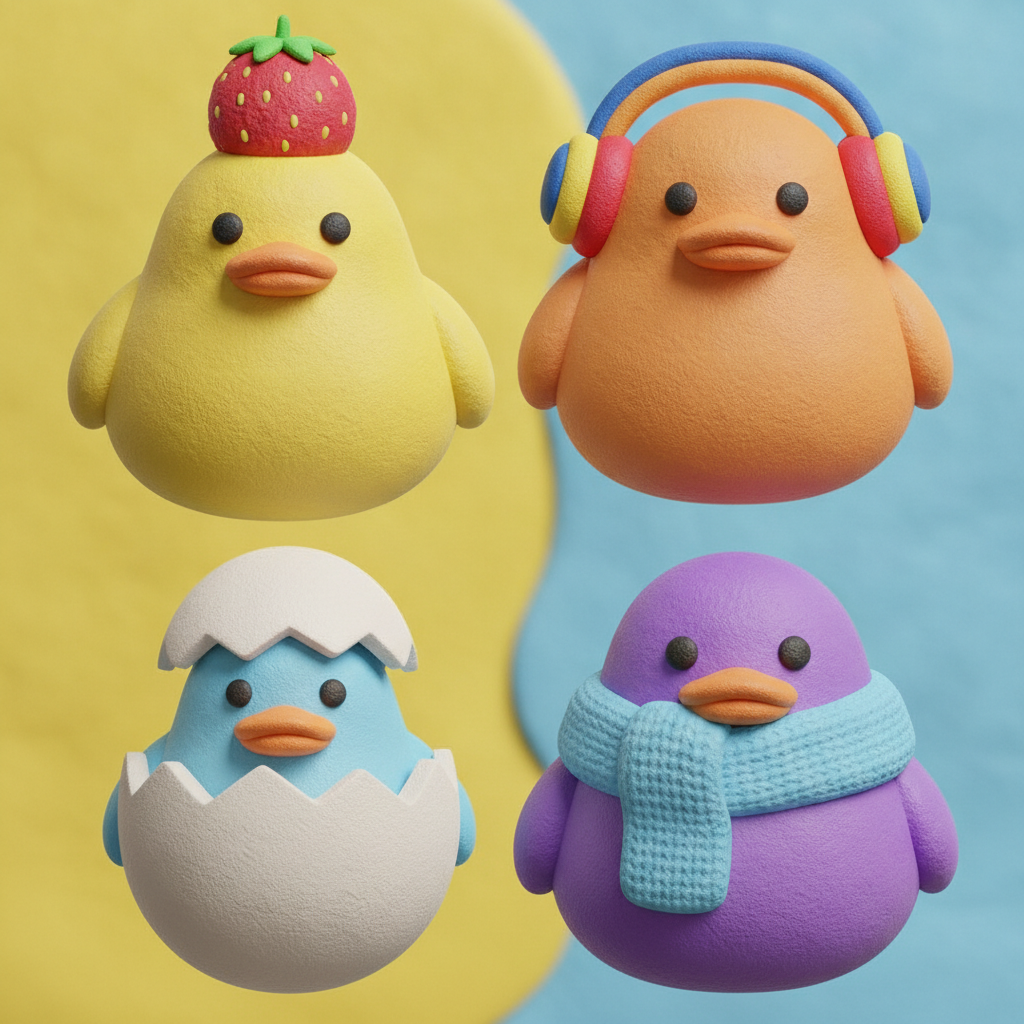
| Subject (sujeito) | Quem ou o que aparece na imagem? | chubby round bodies |
| Style & Medium (estilo e meio) | Como foi feita? Tipo de render, sensação do material, lente | claymation texture, 85mm lens photo |
| Action & Pose (ação e pose) | Pose, olhar, ângulo de câmera e composição | front view, centered composition |
| Attire & Details (vestuário e detalhes) | O que veste ou carrega, pequenos detalhes físicos | knitted blue scarf |
| Environment (ambiente) | O fundo e o cenário | seamless studio backdrop |
| Lighting & Palette (iluminação e paleta) | Luz, sombras e cores | soft studio diffusion, vibrant pastel palette |
A "câmera" no sentido do dia a dia (ângulo, enquadramento) fica em Action & Pose; a lente e o estilo fotográfico ficam em Style & Medium. A lista completa está em Categorias de tags.
Veja o que isso faz com um prompt. A primeira versão é uma única string que só dá para copiar inteira; a segunda é a mesma ideia em peças que você pode combinar:
cute claymation ducks in a 2x2 grid, knitted scarf, strawberry hat, soft studio light, pastel colors, front view, 3d render
- Subject:
four cute duck characters,chubby round bodies - Style & Medium:
3d digital render,claymation texture - Action & Pose:
front view,centered composition - Attire & Details:
strawberry hat,knitted blue scarf - Lighting & Palette:
soft studio diffusion,vibrant pastel palette
Faça em quatro passos com o mysnipbox
- 1Adicione a imagem. Arraste para a janela ou cole. Se Decompose automático ao importar estiver ligado nas configurações, a análise começa assim que a imagem entra; se não, rode o Decompose pelo inspetor.
- 2Deixe um modelo de visão ler a imagem. Quem escolhe o modelo é você: um modelo na nuvem com a sua própria chave de API (Gemini, OpenAI ou Claude), ou um modelo local via Ollama, para que a imagem nunca saia do seu computador. Um provedor na nuvem recebe as imagens que você analisa, então use um modelo local para referências confidenciais. Veja Provedores e Modelos locais.
- 3Leia o resultado por categoria. Todas as tags são organizadas nas seis linhas acima, então você pode pular o sujeito e olhar direto a iluminação.
- 4Clique nas tags que quiser para colocá-las na cesta de prompts. As tags ficam em linhas por categoria, dá para arrastar e reordenar, e o prompt final é atualizado enquanto você trabalha.
Subject
Style & Medium
Attire & Details
Environment
Lighting & Palette
Com um modelo Flash na nuvem, uma análise costuma levar segundos; com um modelo local, depende da sua GPU ou da memória do seu Apple Silicon. De qualquer jeito, você lê um resultado estruturado em vez de um bloco de texto.
Inspetor · Sujeito
Saída do prompt
a {subject} forging a blade in a dim workshop, wearing a {color} leather apron, cinematic lighting, 35mm lens, volumetric fog, hyperdetailed
Troque {subject} e {color} a cada renderização — o restante do modelo permanece travado.
{variable} se juntam na cesta de prompts, com o prompt montado logo abaixo.Reaproveite uma camada e troque o resto
É aqui que separar compensa. Digamos que você adorou a luz da referência, mas quer o seu próprio sujeito. Mantenha as tags de Lighting & Palette e troque o restante:
soft studio diffusion, subtle contact shadow, vibrant pastel palette
a ceramic teapot with a knitted cozy, 3d digital render, claymation texture, front view, soft studio diffusion, subtle contact shadow, vibrant pastel palette
Se você faz isso com frequência, transforme a parte que muda em uma variável como {subject} e salve a cesta como modelo. O formato de saída também é seu: separado por vírgulas, ou unido por sublinhado ou hífen para ferramentas que esperam entrada em estilo de tags. Mais em Cesta de prompts e modelos.
O que isso pode e não pode te dizer
- Ele descreve como a imagem parece, em vocabulário de prompt. Não recupera o prompt original de quem criou, nem a seed, a versão do modelo ou parâmetros como
--are--sref. - Trate as tags como um ótimo ponto de partida: gere, compare com a referência e ajuste uma camada de cada vez.
- Se o resultado ficou fraco, use Re-decompose with Vision LLM com um modelo mais forte, ou aumente a Densidade de extração de tags (Simple, Detailed ou Ultra-Detailed) nas configurações.
- Aprender um estilo não é licença para copiar o trabalho de outra pessoa. Use as referências para entender o que funciona e depois crie algo seu.
Qual modelo deve ler as suas imagens?
Qualquer modelo de visão dá conta de imagens do Midjourney e do Flux. Se você quer uma opção gratuita na nuvem, leia como conseguir uma chave de API do Gemini de graça e configurá-la. Se prefere tudo no seu próprio computador, leia como fazer engenharia reversa de prompts localmente com o Ollama.
Resumo
Pare de chutar uma string longa. Divida a imagem em sujeito, estilo, câmera, iluminação e paleta, fique com a camada de que gosta e troque o resto. Baixe o mysnipbox para macOS e Windows, ou teste o fluxo com imagens de exemplo na demo no navegador.